Статья опубликована в рамках: CXI Международной научно-практической конференции «Современная психология и педагогика: проблемы и решения» (Россия, г. Новосибирск, 19 октября 2026 г.)
Наука: Педагогика
Секция: Информационные технологии в образовании
Скачать книгу(-и): Скачать книгу
дипломов
ЭФФЕКТИВНОСТЬ МЕТОДИКИ ПОДГОТОВКИ ПРЕПОДАВАТЕЛЕЙ К ПРИМЕНЕНИЮ ИСКУССТВЕННОГО ИНТЕЛЛЕКТА: РЕЗУЛЬТАТЫ ПИЛОТНОЙ АПРОБАЦИИ
EFFECTIVENESS OF A METHODOLOGY FOR PREPARING TEACHERS TO USE ARTIFICIAL INTELLIGENCE: RESULTS OF A PILOT STUDY
Аннотация
В статье представлены результаты пилотной апробации методики подготовки преподавателей к применению искусственного интеллекта в педагогической диагностике. Методика построена на человеко-центричной логике «данные – анализ с помощью искусственного интеллекта – интерпретация преподавателем – педагогическое решение – мониторинг». Эффективность оценивалась в дизайне «до – после» на выборке преподавателей вузов (29 анкет до и 25 после обучения, 17 сопоставленных пар) с помощью теста знаний, шкалы самооценки и практического кейса, оценённого по аналитической рубрике. Тест показал эффект потолка: 59 % участников набрали максимальный балл уже до обучения. Средний балл кейса вырос с 7,56 до 8,31 из 10 (р = 0,088; r = 0,58), наиболее заметно – по критерию выбора педагогического действия. Самооценка не изменилась. Сделан вывод, что эффективность подобных программ следует измерять по решению практических кейсов.
Abstract
The article presents the results of a pilot study of a methodology that prepares teachers to use artificial intelligence in pedagogical diagnostics. The methodology follows a human-centred cycle: data, analysis with artificial intelligence, interpretation by the teacher, pedagogical decision and monitoring. Effectiveness was assessed in a pre–post design with university teachers (29 questionnaires before and 25 after training, 17 matched pairs) using a knowledge test, a self-assessment scale and a practical case scored with an analytic rubric. The test showed a ceiling effect: 59 % of participants obtained the maximum score before training. The mean case score rose from 7.56 to 8.31 out of 10 (p = 0.088; r = 0.58), most noticeably in the choice of pedagogical action. Self-assessment did not change. It is concluded that the effectiveness of such programmes should be measured by performance on practical cases.
Ключевые слова: искусственный интеллект в образовании, профессиональное развитие преподавателей, педагогическая диагностика, человеко-центричный подход, практический кейс, аналитическая рубрика, апробация методики.
Keywords: artificial intelligence in education, teacher professional development, pedagogical diagnostics, human-centred approach, practical case, analytic rubric, pilot study.
Введение
Инструменты искусственного интеллекта (ИИ) уже встроены в системы управления обучением: они прогнозируют риск снижения успеваемости, рекомендуют учебные материалы и формируют траектории обучающихся. Однако преподаватель чаще остаётся пользователем готового вывода модели, чем его критическим интерпретатором. Систематический обзор исследований ИИ в высшем образовании показал, что большинство работ сосредоточено на технологиях и почти не описывает роль педагога [1]. Распространение больших языковых моделей обострило вопрос о профессиональной готовности преподавателей к работе с такими системами [2, 3].
Ранее автором совместно с коллегами была предложена модель цифрового обучения с ИИ, направленная на повышение гибкости и доступности образования [4], и проанализированы ограничения рекомендательных систем для образовательных платформ – холодный старт, разреженность данных, предвзятость и недостаточная объяснимость [5]. Работа такой модели на практике зависит от того, способен ли преподаватель правильно прочитать её рекомендацию и принять обоснованное педагогическое решение. Поэтому была разработана методика подготовки преподавателей, включающая интерпретацию рекомендаций ИИ, проектирование AI-агентов и создание прототипов с помощью генеративного ИИ.
Цель исследования – оценить изменение знаний, практического умения и самооценки преподавателей после обучения по методике. Для этого решались задачи: 1) сравнить результаты теста знаний до и после обучения; 2) оценить по аналитической рубрике решение практического кейса; 3) сопоставить изменение самооценки с изменением практического результата; 4) определить, какие инструменты оценки чувствительны к эффекту такого обучения.
Теоретические основы исследования
Международные рамки цифровой и AI-компетентности педагога требуют от него не только умения пользоваться инструментами, но и способности сохранять за собой педагогическое решение. Европейская рамка DigCompEdu описывает цифровую компетентность преподавателя через профессиональную деятельность, оценивание и поддержку обучающихся [6]. Рамка AI-компетенций учителя UNESCO выделяет человеко-центричный подход, этику ИИ и применение ИИ в педагогике в качестве самостоятельных направлений [7]. В модели Intelligent-TPACK использование ИИ рассматривается как сочетание технологического, педагогического, предметного и этического знания [8], а в исследованиях AI-грамотности – как умение понимать, оценивать и применять ИИ в своём контексте [9].
Принцип «человек в контуре решения» предполагает, что система предлагает варианты и показывает пределы своих возможностей, а человек проверяет вывод и отвечает за итоговое решение [10]. В методике этот принцип реализован в цепочке агентов «Диагност – Прогнозист – Методист»: агенты анализируют данные и предлагают варианты воздействия, а окончательное решение принимает преподаватель.
Оценка программ профессионального развития часто ограничивается удовлетворённостью участников и их самоотчётом, то есть первым уровнем модели Киркпатрика [11]. Т. Гаски и Л. Десимоне подчёркивают, что эффект обучения преподавателей следует измерять по изменению их знаний и профессиональной практики [12, 13]. Это определило выбор инструментов исследования: наряду с тестом и самооценкой в него включён практический кейс, моделирующий реальную ситуацию педагогической диагностики.
Материалы и методы исследования
Использован дизайн одной группы с двумя замерами: входная диагностика (T0) до обучения и выходная (T1) после него. Апробация проведена 22 сентября – 1 октября 2026 г. в нескольких группах; анкеты заполнялись в Google Forms. Участие было добровольным, данные обезличены.
В анализ включены 29 анкет T0 и 25 анкет T1; пробные заполнения организатора исключены. 28 из 29 участников работают в вузе и имеют педагогический стаж до 3 лет. По коду участника сопоставлены 17 пар T0–T1, для практического кейса – 16 пар (один участник не выполнил кейс ни в одной волне).
Анкеты T0 и T1 являлись параллельными формами с одинаковой структурой и разным содержанием заданий. Они включали:
– тест знаний из 20 вопросов с выбором ответа (интерпретация риска, цифровой след, рекомендательные системы, объяснимый ИИ, AI-агенты, минимизация данных, прототипирование), 0–20 баллов;
– шкалу самооценки из 10 утверждений «Я могу…», соответствующих шагам методики, 1–5 баллов (α Кронбаха 0,94 в T0 и 0,95 в T1);
– практический кейс: синтетическую учебную группу из 10 обучающихся с четырьмя показателями (успеваемость, посещаемость, активность, темп) и пять открытых заданий, повторяющих цикл методики. В кейс T1 включён обучающийся-«ловушка» с низкой активностью при высокой успеваемости.
Поскольку в форме кейс не оценивался, ответы оценены автором по аналитической рубрике (таблица 1). Согласованность критериев рубрики высокая: α = 0,84 в T0 и 0,89 в T1.
Таблица 1.
Рубрика оценки практического кейса
| Критерий | 2 балла | 1 балл |
|---|---|---|
| К1. Выбор обучающихся | не более трёх обучающихся из зоны риска, для каждого названы показатели | номера без показателей или один обучающийся вне зоны риска |
| К2. Недостающие данные | названы не менее двух видов данных (причины, динамика, ошибки по темам, обратная связь) | назван один вид данных или формулировка размыта |
| К3. Педагогическое действие | конкретное действие для каждого обучающегося с учётом его профиля | общее действие для всех или только для части обучающихся |
| К4. Срок и показатель | указаны срок и измеримый показатель повторной оценки | указан только срок или только показатель |
| К5. Ограничение анализа | чётко названо ограничение (только количественные данные, нет причинности, срез без динамики) | ограничение названо размыто |
0 баллов ставился за отсутствие ответа по существу; пустые и символьные ответы («1», «.») считались пропуском.
Распределения показателей смещены к максимуму, поэтому применялись непараметрические критерии: критерий знаковых рангов Уилкоксона для связанных выборок и критерий Манна – Уитни для сравнения всех анкет. Величина эффекта оценивалась ранго-бисериальной корреляцией r [14]. Для проверки устойчивости анализ повторён без трёх пар, в которых анкета T1 отправлена раньше T0, и без двух пар с почти дословно совпадающими ответами (сходство текста более 70 %). Расчёты выполнены в Python (библиотека SciPy).
Результаты исследования
Ни один показатель не изменился статистически значимо; наибольший прирост показал практический кейс (таблица 2).
Таблица 2.
Изменение показателей до (T0) и после (T1) обучения, парные данные
| Показатель | n пар | T0, M (SD) | T1, M (SD) | Рост / без изм. / сниж. | p | r |
|---|---|---|---|---|---|---|
| Тест знаний, 0–20 | 17 | 18,76 (2,33) | 19,24 (2,66) | 6 / 10 / 1 | 0,233 | 0,50 |
| Практический кейс, 0–10 | 16 | 7,56 (2,61) | 8,31 (3,01) | 7 / 5 / 4 | 0,088 | 0,58 |
| Самооценка, 1–5 | 17 | 3,53 (0,54) | 3,51 (0,61) | 4 / 9 / 4 | 0,944 | 0,03 |
Примечание: p – критерий Уилкоксона; r – ранго-бисериальная корреляция.
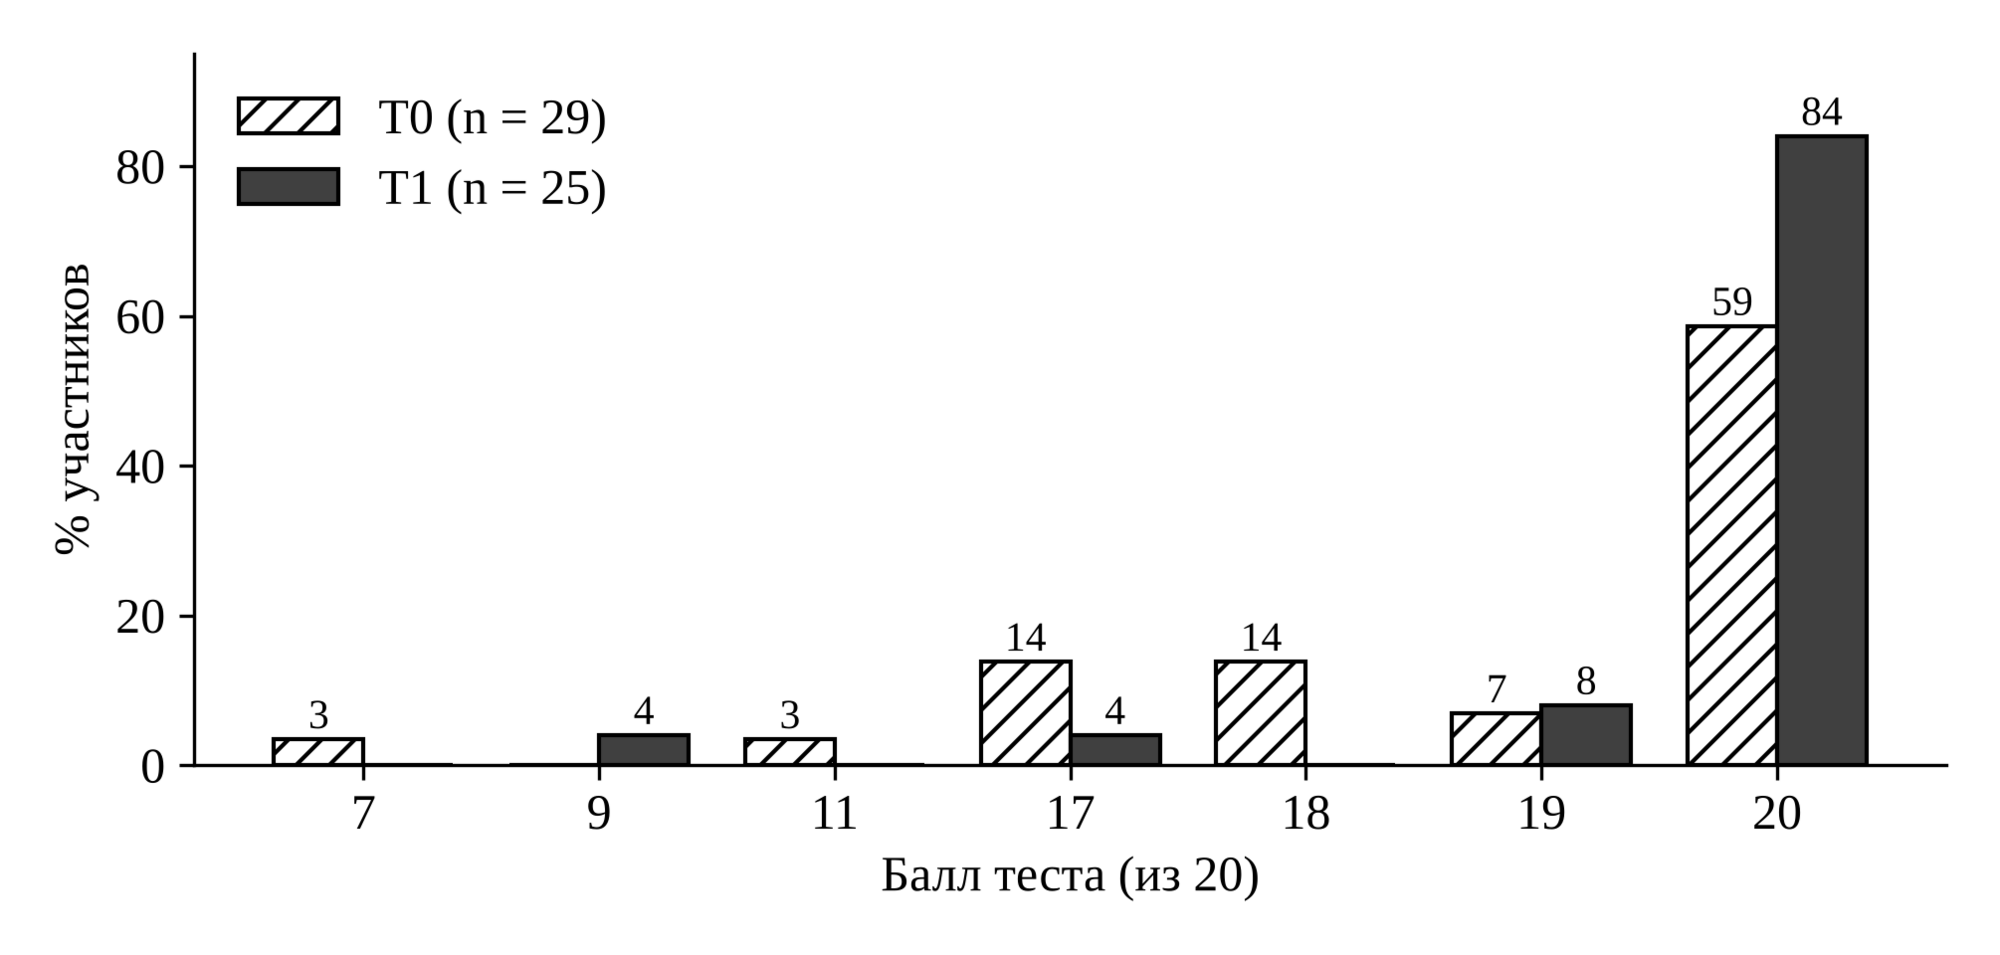
Тест знаний. Уже на входе 59 % участников набрали 20 баллов из 20 и 79 % – не менее 18 баллов; после обучения максимальный балл получили 84 % (рис. 1). Для 11 из 17 пар рост был невозможен. Все шесть участников, у которых оставался запас для роста, повысили балл; один участник снизил его с 20 до 9. При сравнении всех анкет разница значима (18,48 против 19,36; U = 267,5; p = 0,042), однако это сравнение не учитывает различие состава выборок.
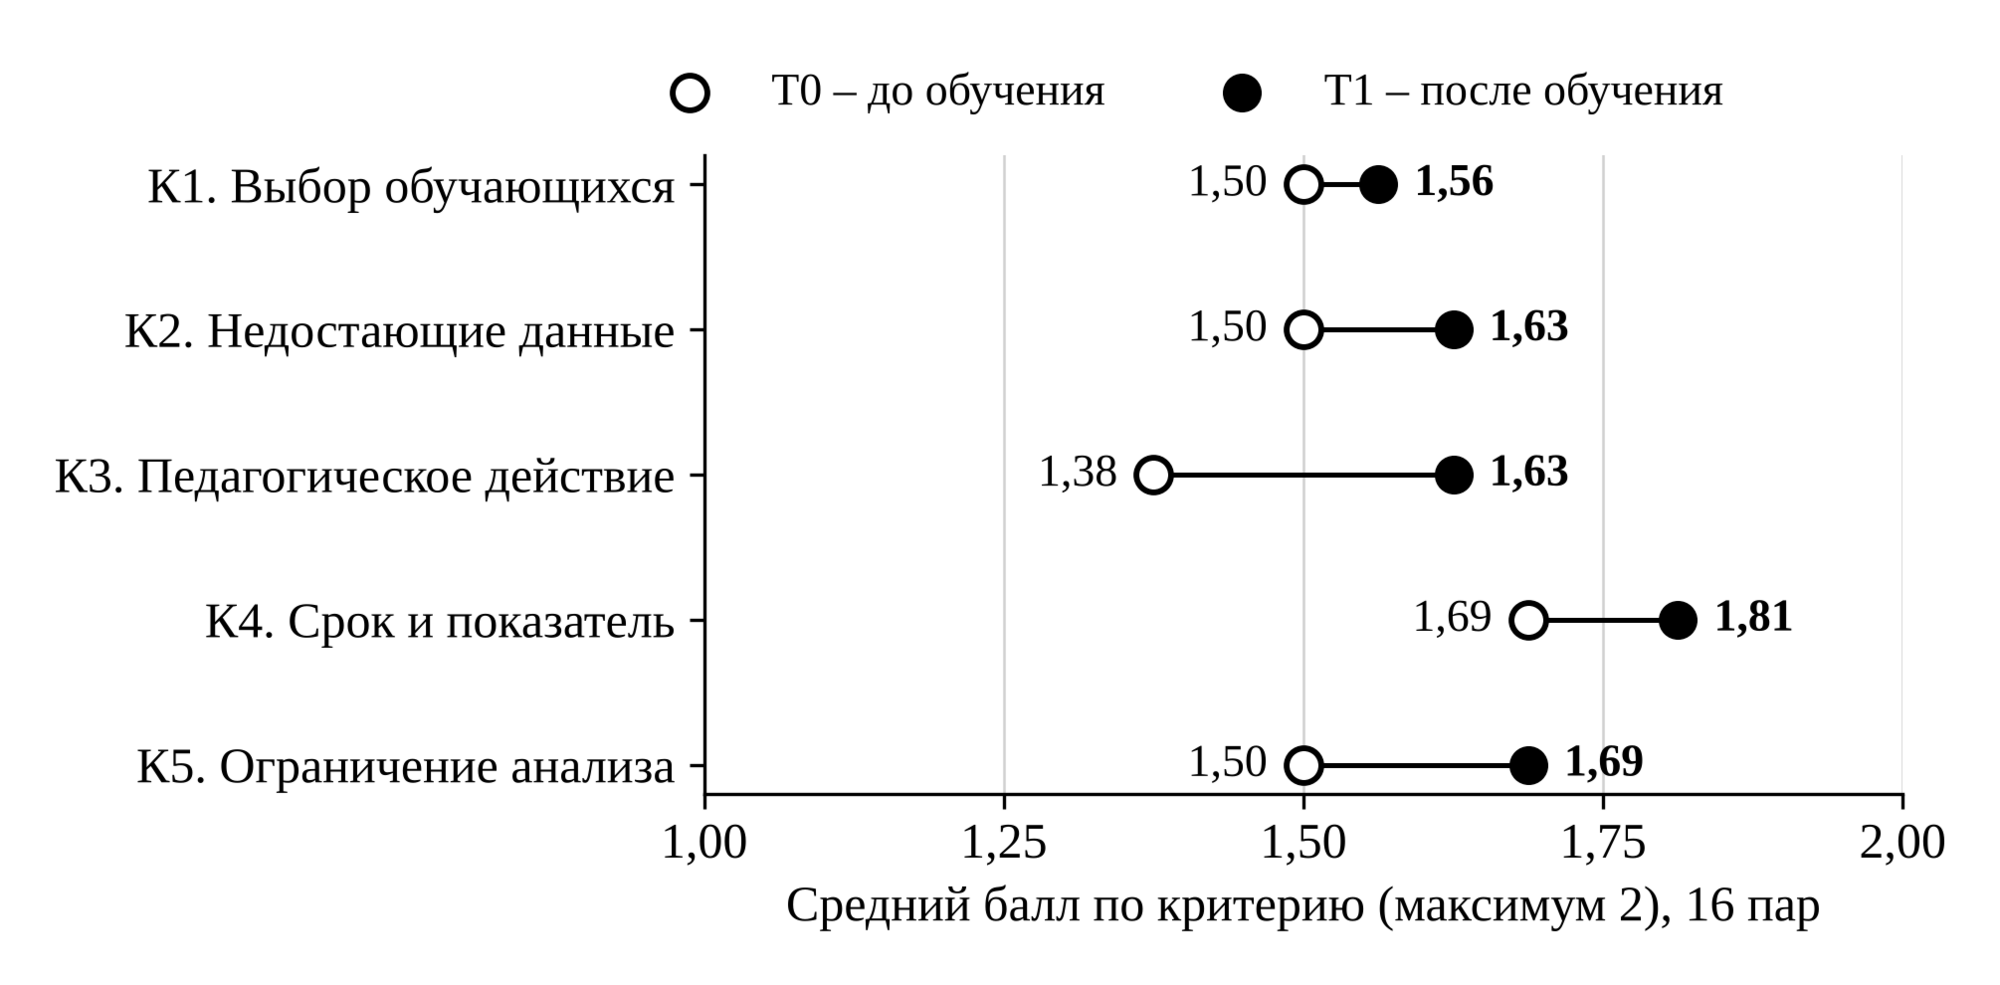
Практический кейс. Средний балл вырос на 0,75 при большой величине эффекта (r = 0,58), однако значимость не достигнута. Шесть участников уже в T0 набрали 10 баллов из 10; из остальных десяти семеро улучшили результат на 1–4 балла. Рост отмечен по всем пяти критериям рубрики, сильнее всего – по критерию К3 «педагогическое действие» (рис. 2): после обучения участники чаще предлагали отдельное действие для каждого обучающегося вместо общего «повысить мотивацию».
Самооценка. Средний балл не изменился, и ни по одному из 10 утверждений сдвиг не превысил 0,18 балла (все p > 0,25). 16 из 29 участников T0 поставили всем утверждениям одинаковый балл, поэтому высокий коэффициент α отражает скорее шаблонное заполнение, чем качество шкалы.
Проверка устойчивости. Без трёх пар с обратным порядком отправки анкет прирост по кейсу увеличился до 1,0 балла (7,15 → 8,15; n = 13; p = 0,055). После исключения ещё двух пар с почти дословно совпадающими ответами прирост сократился до 0,64 балла (n = 11; p = 0,22). По тесту и самооценке выводы не изменились.
Обсуждение результатов
Эффект обучения проявился там, где преподавателю нужно было применить методику, а не узнать верный ответ. Тест с выбором ответа оказался для этой аудитории слишком лёгким: верные варианты («проверить контекст», «решение принимает преподаватель») угадываются по здравому смыслу. В кейсе требовалось самостоятельно выбрать обучающихся, обосновать выбор и предложить действие, и именно здесь заметен сдвиг. Это согласуется с рекомендацией оценивать профессиональное развитие по изменению практики педагога [12, 13].
Наибольший прирост по критерию К3 показывает, что методика лучше всего учит переходу от сигнала модели к адресному действию. Это центральный шаг человеко-центричной логики [10] и условие того, чтобы адаптивность модели цифрового обучения [4] выразилась в поддержке конкретного обучающегося. Самооценка при этом не выросла: участники с небольшим стажем оценивают себя осторожно, и одно занятие может не изменить эту оценку даже при росте умения.
Исследование имеет ограничения. Контрольная группа отсутствовала, выборка мала (16–17 пар), поэтому даже большой эффект не достигает значимости. Анкеты T0 и T1 часто отправлялись в конце занятия с разницей в несколько минут, и часть входных ответов могла быть дописана после обучения, что занижает измеренный эффект. Код участника вводился вручную, и 8 анкет T1 не удалось связать с T0. Часть ответов на кейс подготовлена с помощью чат-бота: они отражают умение работать с ИИ, но не обязательно самостоятельное решение. Кейс оценивался одним экспертом, межэкспертная согласованность не проверялась.
Заключение
Пилотная апробация показала положительную тенденцию: после обучения преподаватели решают практический кейс на 0,75–1,0 балла из 10 лучше (r = 0,58), особенно в части выбора адресного педагогического действия. Тест знаний и самооценка оказались нечувствительны к эффекту из-за эффекта потолка и шаблонного заполнения, поэтому основным показателем эффективности подобных программ следует считать решение практического кейса по рубрике.
На следующем этапе планируется выдавать участникам код заранее и проводить выходную диагностику через 1–2 недели после обучения, закрывая входную анкету до его начала; усложнить тест вопросами на применение и оценивать кейс двумя экспертами; ввести контрольную группу и отложенный замер для оценки устойчивости эффекта.
Данное исследование финансировалось/финансируется Комитетом по науке Министерства науки и высшего образования Республики Казахстан (грант № AP23488869).
Список литературы
- Zawacki-Richter O., Marín V.I., Bond M., Gouverneur F. Systematic review of research on artificial intelligence applications in higher education – where are the educators? // International Journal of Educational Technology in Higher Education. – 2019. – Т. 16. – DOI: 10.1186/s41239-019-0171-0.
- Kasneci E. Seßler K., Küchemann S. [et al.]. ChatGPT for good? On opportunities and challenges of large language models for education // Learning and Individual Differences. – 2023. – Т. 103. – Art. 102274. – DOI: 10.1016/j.lindif.2023.102274.
- Holmes W., Bialik M., Fadel C. Artificial intelligence in education: promises and implications for teaching and learning. – Boston: Center for Curriculum Redesign, 2019. – 228 P.
- Iklassova K., Abdullah L.N., Shaikhanova A., Bazarova M., Tashibayev R. A digital learning model with artificial intelligence to increase the flexibility and accessibility of education // International Journal of Innovative Research and Scientific Studies. – 2025. – Т. 8, № 6. – P. 1504–1512. – DOI: 10.53894/ijirss.v8i6.9951.
- Икласова К.Е., Шайханова А.К., Базарова М.Ж., Ташибаев Р.М., Казанбаева А.С. Обзор рекомендательных систем: модели и перспективы использования в образовательных платформах // Вестник университета Шакарима. Технические науки. – 2025. – № 1 (17). – С. 12–20.
- Redecker C. European framework for the digital competence of educators: DigCompEdu / ed. by Y. Punie. – Luxembourg: Publications Office of the European Union, 2017. – 95 P. – DOI: 10.2760/159770.
- Miao F., Cukurova M. AI competency framework for teachers. – Paris: UNESCO, 2024. – DOI: 10.54675/ZJTE2084.
- Celik I. Towards Intelligent-TPACK: an empirical study on teachers’ professional knowledge to ethically integrate artificial intelligence (AI)-based tools into education // Computers in Human Behavior. – 2023. – Т. 138. – Art. 107468. – DOI: 10.1016/j.chb.2022.107468.
- Ng D.T.K., Leung J.K.L., Chu S.K.W., Qiao M.S. Conceptualizing AI literacy: an exploratory review // Computers and Education: Artificial Intelligence. – 2021. – Т. 2. – Art. 100041. – DOI: 10.1016/j.caeai.2021.100041.
- Amershi S., Weld D., Vorvoreanu M. [et al.]. Guidelines for human-AI interaction // Proceedings of the. – New York: ACM, 2019. – DOI: 10.1145/3290605.3300233.
- Kirkpatrick D.L., Kirkpatrick J.D. Evaluating training programs: the four levels. 3rd ed. – San Francisco: Berrett-Koehler, 2006. – 379 P.
- Guskey T.R. Evaluating professional development. – Thousand Oaks: Corwin Press, 2000. – 307 P.
- Desimone L.M. Improving impact studies of teachers’ professional development: toward better conceptualizations and measures // Educational Researcher. – 2009. – Т. 38, № 3. – P. 181–199. – DOI: 10.3102/0013189X08331140.
- Kerby D.S. The simple difference formula: an approach to teaching nonparametric correlation // Comprehensive Psychology. – 2014. – Т. 3. – DOI: 10.2466/11.IT.3.1.
дипломов