Статья опубликована в рамках: CLXVII Международной научно-практической конференции «Научное сообщество студентов XXI столетия. ТЕХНИЧЕСКИЕ НАУКИ» (Россия, г. Новосибирск, 05 ноября 2026 г.)
Наука: Информационные технологии
Скачать книгу(-и): Скачать книгу
СРАВНИТЕЛЬНЫЙ АНАЛИЗ ОБЪЕКТНОЙ АРХИТЕКТУРЫ XGBOOST, LIGHTGBM И CATBOOST

COMPARATIVE ANALYSIS OF THE OBJECT ARCHITECTURE OF XGBOOST, LIGHTGBM AND CATBOOST
Аннотация
Цель: сравнить объектно-ориентированное устройство библиотек градиентного бустинга XGBoost, LightGBM и CatBoost. Метод: разбор контейнеров данных, моделей, функций обучения и sklearn-обёрток с точки зрения абстракции, инкапсуляции, наследования и полиморфизма, поиск паттернов проектирования, оценка по SOLID и тесты scikit-learn. Результат: библиотеки построены по одной схеме «данные — модель — обучение — обёртка»; XGBoost и LightGBM связаны с scikit-learn наследованием, CatBoost — утиной типизацией; обёртки проходят 50 из 52, 57 из 59 и 33 из 59 тестов. Выводы: XGBoost и LightGBM аккуратнее разделяют обязанности, CatBoost ради удобства собирает почти всё в одном классе.
Abstract
Background: to compare the object-oriented design of the gradient boosting libraries XGBoost, LightGBM and CatBoost. Methods: analysis of data containers, models, training functions and scikit-learn wrappers in terms of abstraction, encapsulation, inheritance and polymorphism, identification of design patterns, assessment against SOLID and scikit-learn checks. Result: the libraries follow the same “data — model — training — wrapper” scheme; XGBoost and LightGBM connect to scikit-learn through inheritance, CatBoost through duck typing; the wrappers pass 50 of 52, 57 of 59 and 33 of 59 checks. Conclusion: XGBoost and LightGBM divide responsibilities more carefully, while CatBoost puts almost everything into one class for convenience.
Ключевые слова: объектно-ориентированное программирование, наследование, полиморфизм, паттерны проектирования, SOLID, градиентный бустинг, XGBoost, LightGBM, CatBoost, scikit-learn.
Keywords: object-oriented programming, inheritance, polymorphism, design patterns, SOLID, gradient boosting, XGBoost, LightGBM, CatBoost, scikit-learn.
Введение
Градиентный бустинг над деревьями решений [1] — один из самых популярных методов машинного обучения для табличных данных; на практике его берут из библиотек XGBoost [2], LightGBM [3] или CatBoost [4]. Их алгоритмы описаны подробно, а об устройстве программных интерфейсов — какие в них классы и как они связаны — написано гораздо меньше.
От устройства интерфейса зависит, насколько легко подключить модель к остальному коду, заменить одну библиотеку другой или добавить что-то своё. Все три библиотеки предлагают «родной» интерфейс и интерфейс в стиле scikit-learn [5] — стандартной библиотеки машинного обучения на Python.
Цель работы — рассмотреть интерфейсы трёх библиотек как объектно-ориентированные системы: выяснить, как в них реализованы абстракция, инкапсуляция, наследование и полиморфизм, найти известные паттерны проектирования, оценить интерфейсы по принципам SOLID и проверить, насколько точно они соблюдают соглашения scikit-learn [6].
1. Материалы и методы
Исследовались XGBoost 3.4.1, LightGBM 4.7.0 и CatBoost 1.2.10 для Python 3.13. Сначала изучались исходный код и документация библиотек [7–9]: какие в них есть классы, от чего они наследуются и что происходит при обучении. Затем найденные решения сравнивались с четырьмя принципами объектно-ориентированного программирования [10], каталогом паттернов проектирования [11] и принципами SOLID [12].
Затем к регрессору каждой библиотеки (20 деревьев, остальные параметры по умолчанию) применялась функция check_estimator из scikit-learn 1.9.1, автоматически запускающая несколько десятков тестов на соблюдение соглашений scikit-learn [13], и пять типовых сценариев на синтетических данных (300 объектов, 8 признаков): копирование модели, чтение и изменение параметров, Pipeline, GridSearchCV и кросс-валидация.
2. Общая схема
Три библиотеки разрабатывались независимо, но пришли к одной схеме из четырёх уровней (рис. 1). Контейнер данных хранит признаки и ответы в удобном для библиотеки виде; модель — обученный набор деревьев, умеющий делать прогнозы; функция обучения получает параметры и данные и возвращает модель; sklearn-обёртка прячет всё это за привычными методами fit и predict.
Python-классы — лишь тонкая оболочка над ядром на C++. Главное различие заметно сразу: в CatBoost один класс CatBoost и хранит модель, и обучает её, и предоставляет интерфейс scikit-learn.
3. Контейнеры данных
Сильнее всего библиотеки различаются хранением данных. DMatrix в XGBoost создаётся сразу и принимает данные почти любого вида — массивы NumPy, таблицы pandas и polars, разреженные матрицы, файлы; его разновидность QuantileDMatrix экономит память, заменяя значения признаков номерами интервалов.
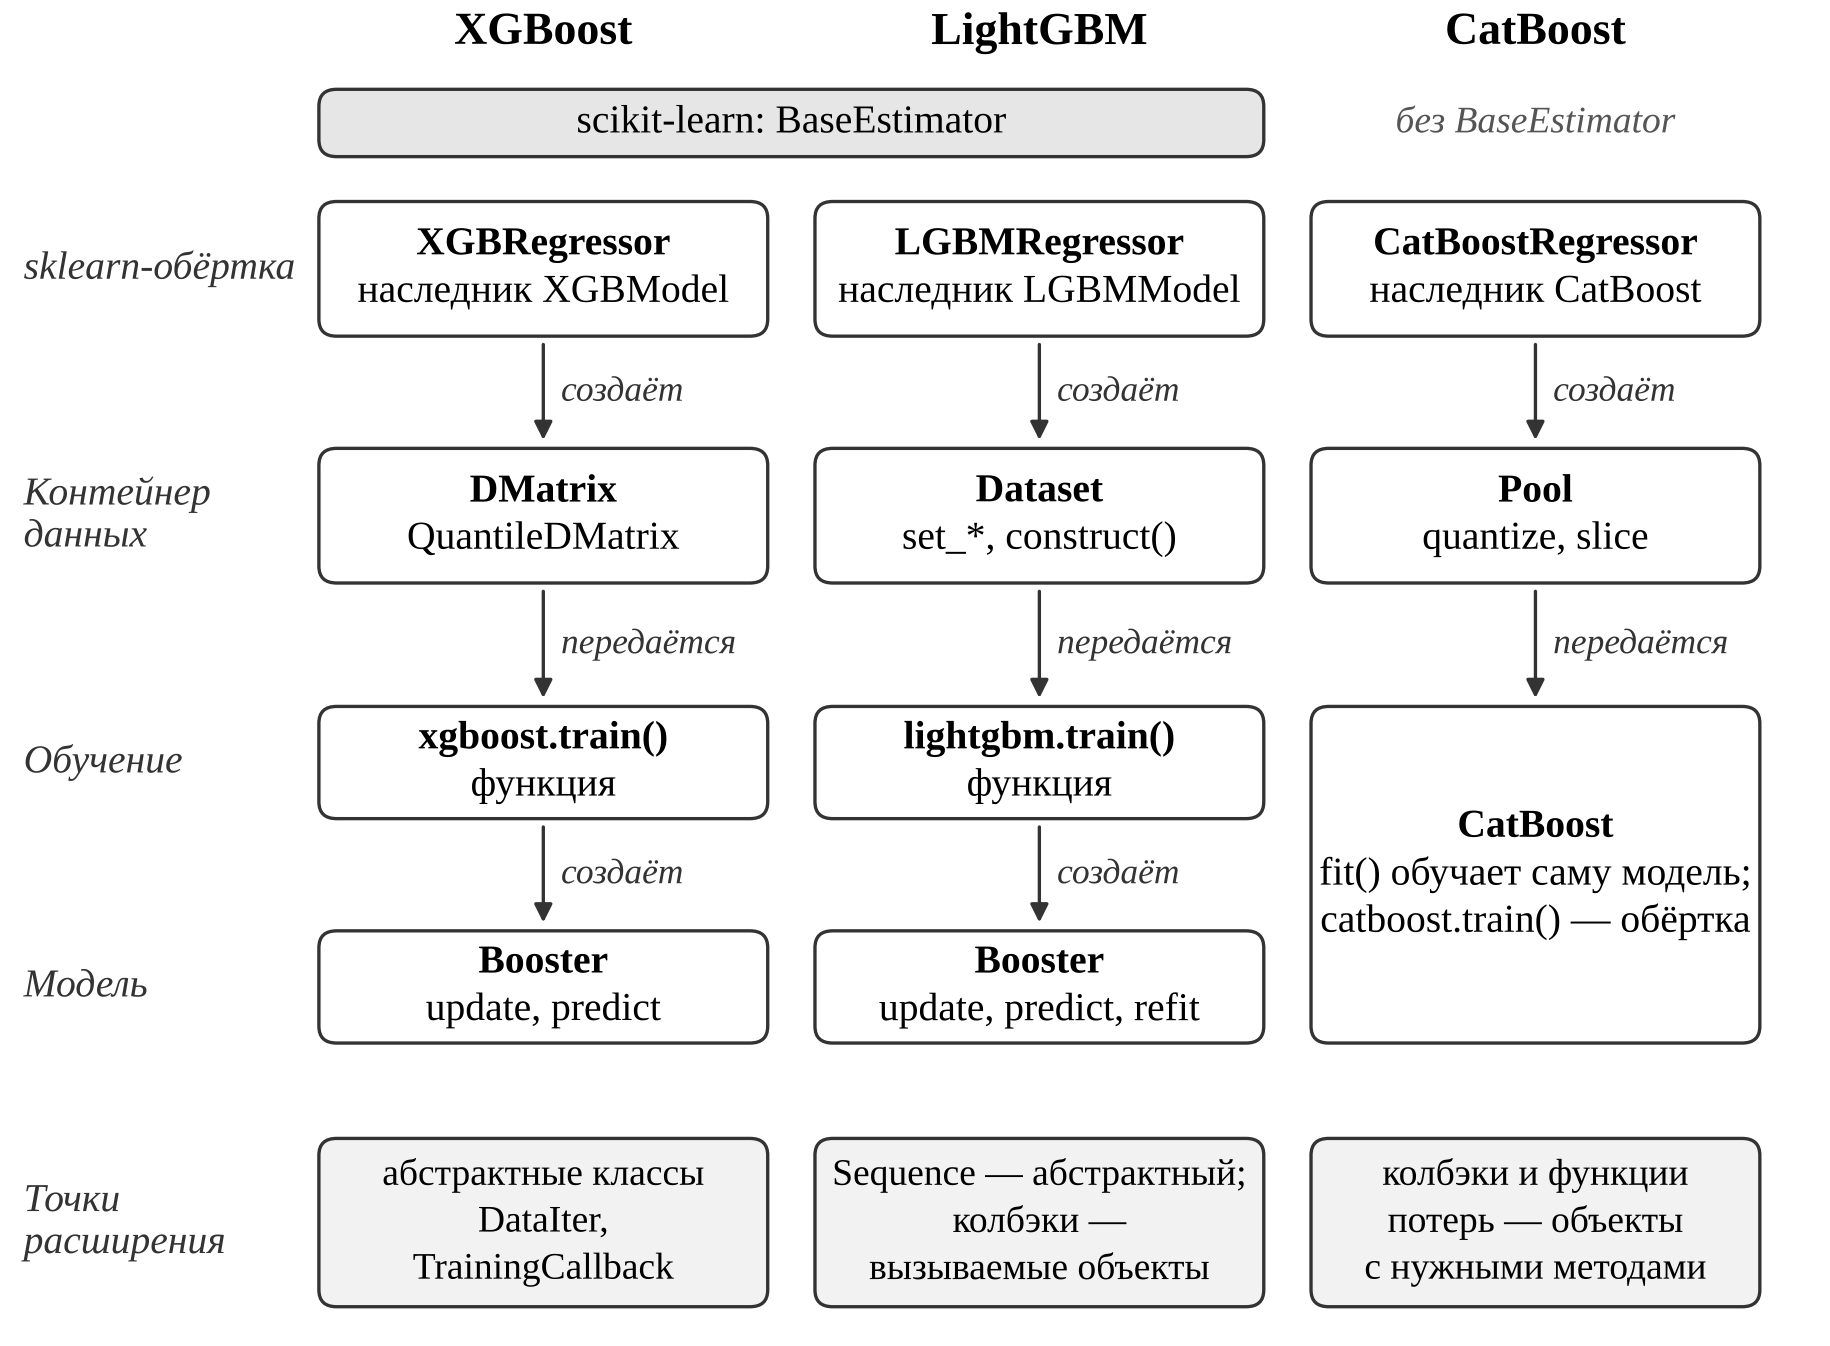
Dataset в LightGBM, наоборот, «ленивый»: при создании он только запоминает данные, а объект в ядре строится в начале обучения; до этого набор можно дополнять метками и весами. Pool в CatBoost — самый многофункциональный: он понимает категориальные и текстовые признаки, данные для ранжирования и файлы, беря на себя часть предобработки.
4. Модели и обучение
В XGBoost и LightGBM обучение оформлено как функция: train принимает параметры и контейнер данных, создаёт модель — объект Booster — и шаг за шагом добавляет в неё деревья. Booster отвечает только за готовую модель: прогноз, сохранение, важность признаков.
В CatBoost модель обучает сама себя методом fit, а функция catboost.train лишь вызывает fit, принимая аргументы с теми же именами, что и xgboost.train.
5. Принципы ООП в интерфейсах библиотек
Объектно-ориентированное программирование опирается на четыре принципа: абстракцию, инкапсуляцию, наследование и полиморфизм [10]. Рассмотрим, как каждый из них реализован в трёх библиотеках (табл. 1).
Таблица 1.
Принципы ООП в интерфейсах XGBoost, LightGBM и CatBoost
| Принцип | XGBoost | LightGBM | CatBoost |
|---|---|---|---|
| Абстракция | абстрактные классы TrainingCallback и DataIter | абстрактный класс Sequence | базовые классы для своих функций потерь |
| Инкапсуляция | объект ядра меняется только через методы | Dataset скрывает момент построения | параметры во внутреннем словаре |
| Наследование | XGBRegressor → XGBModel → BaseEstimator | LGBMRegressor → LGBMModel → BaseEstimator | CatBoostRegressor → CatBoost |
| Полиморфизм колбэков | через наследование | утиная типизация | утиная типизация |
| Композиция | обёртка хранит Booster | обёртка хранит Booster | модель и обучение в одном объекте |
Абстракция — выделение главного и сокрытие деталей. Пользователь работает с понятными сущностями «данные», «модель», «обучение», не думая о том, как деревья хранятся в ядре на C++. Самый явный пример — абстрактные классы: TrainingCallback в XGBoost описывает, что такое колбэк, но не говорит, что именно он делает; так же Sequence в LightGBM описывает источник данных.
Инкапсуляция — объединение данных и методов в объекте и сокрытие его состояния. Каждый Python-объект хранит ссылку на объект ядра и меняет его только через свои методы, а в LightGBM пользователь даже не замечает, когда Dataset превращается из «черновика» в объект ядра. Строгого запрета Python не даёт: «внутренние» поля лишь помечаются подчёркиванием, например, _handle.
Наследование — создание класса на основе существующего. На нём построены sklearn-обёртки XGBoost и LightGBM: XGBRegressor наследует XGBModel, а тот — BaseEstimator из scikit-learn, поэтому методы get_params и set_params обёртка получает готовыми. В CatBoost цепочка короче: CatBoostRegressor наследует CatBoost, но не BaseEstimator, и работу с параметрами реализует сам — с отступлением от правил: из 112 параметров конструктора get_params по умолчанию возвращает один, хотя должен возвращать все [13].
Полиморфизм — работа с разными объектами через один интерфейс. Благодаря ему модели трёх библиотек взаимозаменяемы в scikit-learn: Pipeline и GridSearchCV вызывают fit и predict, не зная, какая библиотека внутри. Реализован он двумя способами, что хорошо видно на колбэках — объектах, которые вызываются после каждой итерации обучения (рис. 2). XGBoost использует полиморфизм через наследование: колбэк обязан быть наследником TrainingCallback. LightGBM и CatBoost полагаются на «утиную типизацию»: подойдёт любая функция или любой объект с методом after_iteration. По этому же принципу scikit-learn принимает CatBoostRegressor за свою модель.
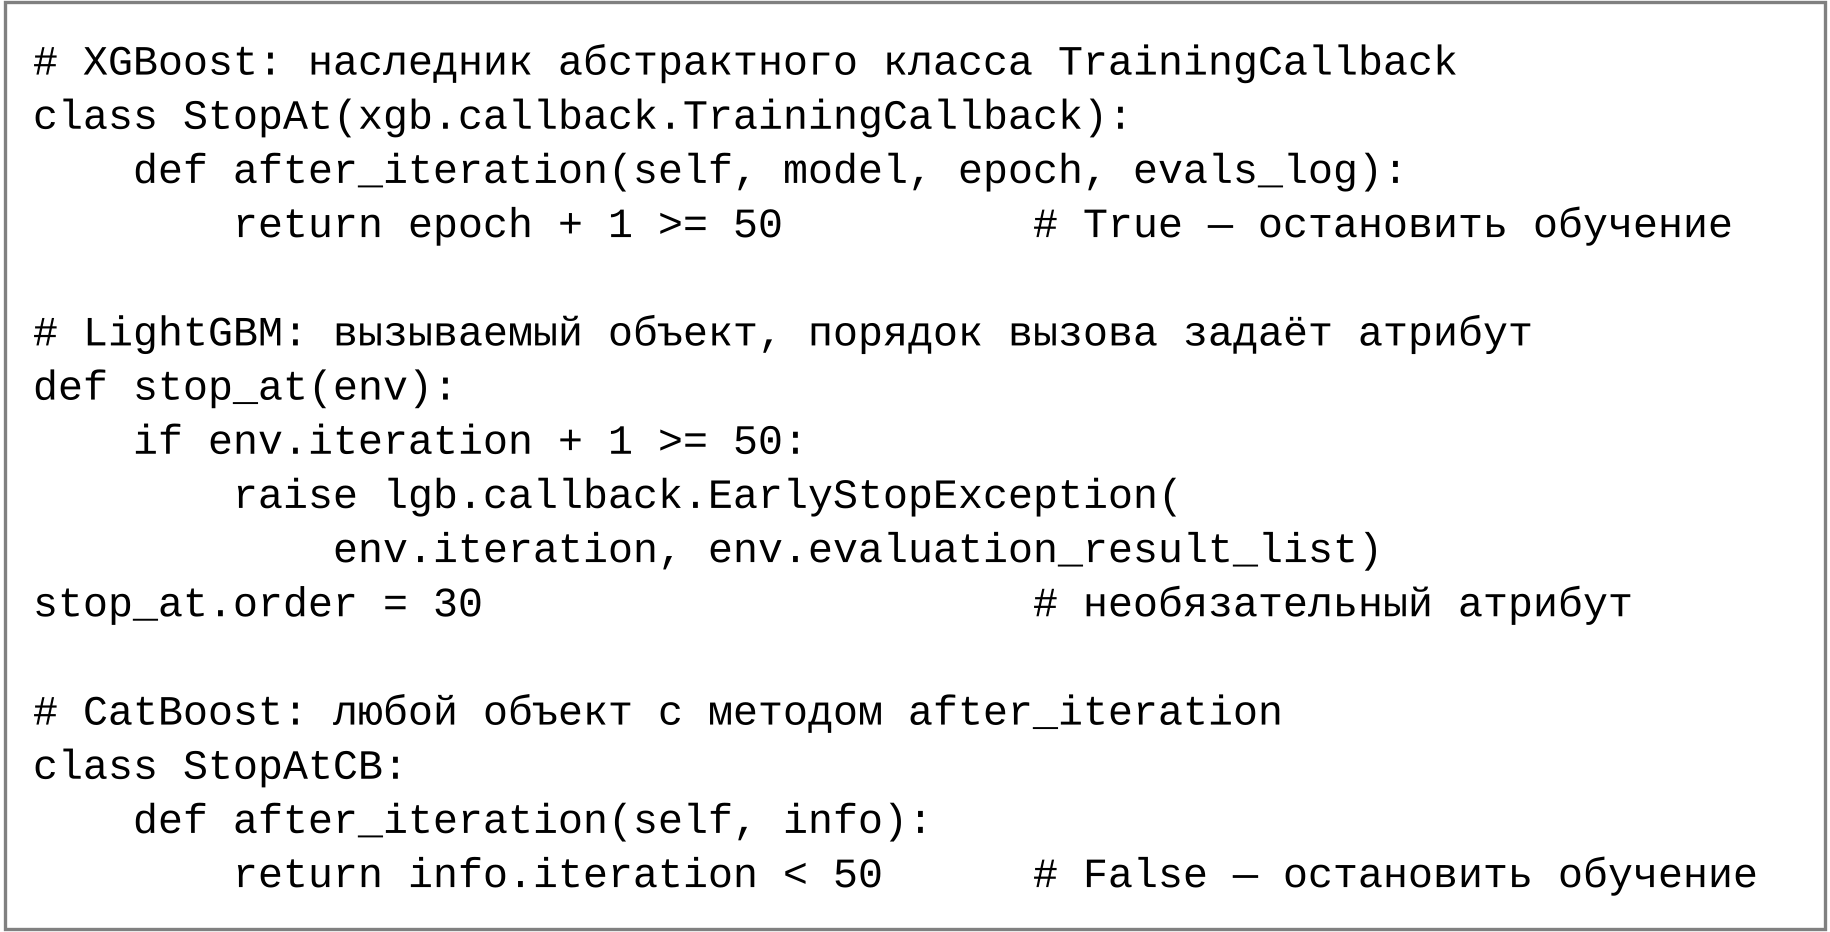
Так же устроены собственные функции потерь: в XGBoost и LightGBM это функция, возвращающая градиент и гессиан, в CatBoost — объект с методом calc_ders_range. Все три примера с рисунка 2 работоспособны и останавливают обучение на 50-м дереве.
Помимо наследования используется композиция — включение одного объекта в другой: sklearn-обёртки XGBoost и LightGBM не наследуют Booster, а хранят его внутри, следуя совету «предпочитайте композицию наследованию» [11]. В CatBoost модель и обучение объединены в одном классе с 58 публичными методами и свойствами.
6. Паттерны проектирования
Паттерн проектирования — типовое, многократно проверенное решение часто встречающейся задачи организации кода [11]. Найденные паттерны сведены в таблицу 2. Главный из них — Adapter: sklearn-обёртки «переводят» интерфейс scikit-learn на язык родного интерфейса, а контейнеры приводят данные разных форматов к единому виду. Builder ярче всего виден в «ленивом» Dataset, а Template Method — в абстрактных классах XGBoost, где библиотека управляет процессом, а пользователь дописывает отдельные шаги.
Таблица 2.
Паттерны проектирования в XGBoost, LightGBM и CatBoost
| Паттерн | Суть | Где встречается |
|---|---|---|
| Adapter | приводит один интерфейс к другому | sklearn-обёртки; приём данных разных форматов; catboost.train |
| Factory Method | отдельный метод решает, какой объект создать | выбор между DMatrix и QuantileDMatrix в обёртке XGBoost |
| Builder | объект собирается по шагам | Dataset в LightGBM; QuantileDMatrix из частей |
| Template Method | алгоритм задан, отдельные шаги пишет пользователь | абстрактные классы XGBoost; Sequence в LightGBM |
| Strategy | алгоритм передаётся как сменный объект | собственные функции потерь и метрики |
| Observer | объекты получают уведомления о событиях | колбэки во всех трёх библиотеках |
7. Оценка по принципам SOLID
Принципы SOLID — пять правил, которые помогают делать объектно-ориентированный код понятным и легко изменяемым [12]. Прежде чем перейти к ним, рассмотрим результаты эксперимента (табл. 3).
Все три обёртки работают в пяти типовых сценариях, но формальная проверка выявила разницу. XGBoost и LightGBM не прошли по одному тесту: первый в редком случае возвращает прогноз пониженной точности, второй не сообщает об ошибке при нулевых весах всех объектов. CatBoost не прошёл 23 различных теста: в 11 случаях он выбрасывает собственное исключение вместо стандартного, 6 связаны с неподдерживаемыми форматами данных, 3 — с приёмом некорректных, по меркам scikit-learn, данных; 22 из них разработчики сами перечислили в коде как известные. Числа в таблице 3 больше, так как часть тестов CatBoost запускается несколько раз, а у каждой библиотеки один тест пропущен.
Таблица 3.
Результаты проверки sklearn-обёрток
| Показатель | XGBoost | LightGBM | CatBoost |
|---|---|---|---|
| Наследует BaseEstimator | да | да | нет |
| Параметров в конструкторе | 40 | 19 | 112 |
| Параметров, возвращаемых get_params | 40 | 19 | 1 |
| Публичных методов и свойств | 23 | 21 | 59 |
| Пройдено тестов check_estimator | 50 из 52 | 57 из 59 | 33 из 59 |
| Типовые сценарии | 5 из 5 | 5 из 5 | 5 из 5 |
S — единственная ответственность: у класса одна задача. XGBoost и LightGBM разносят данные, модель, обучение и sklearn-интерфейс по разным классам, CatBoost собирает почти всё в одном. O — открытость/закрытость: расширение без изменения кода; здесь хороши все три библиотеки. L — подстановка Лисков: наследник работает везде, где родитель. Обёртки XGBoost и LightGBM почти полностью заменяют модели scikit-learn, CatBoost — лишь в типовых случаях.
I — разделение интерфейсов: лучше несколько небольших интерфейсов, чем один огромный; у LightGBM в конструкторе 19 параметров, у XGBoost — 40, у CatBoost — 112. D — инверсия зависимостей: опора на абстракции. Обучение работает с колбэками через общий интерфейс, но sklearn-обёртки сами создают конкретные контейнеры данных.
Заключение
XGBoost, LightGBM и CatBoost, несмотря на независимую разработку, устроены по одной схеме «контейнер данных — модель — функция обучения — sklearn-обёртка» и используют одни и те же паттерны, но по-разному применяют принципы ООП. XGBoost — самая «классическая» библиотека: абстрактные классы, полиморфизм через наследование, композиция в обёртках. LightGBM сочетает наследование в обёртках с утиной типизацией колбэков и «ленивыми» данными. CatBoost опирается на утиную типизацию и ради удобства собирает почти всё в одном классе. Поэтому обёртки XGBoost и LightGBM можно использовать как обычные модели scikit-learn, а при встраивании CatBoost стоит проверить обработку ошибок и нестандартных данных.
Список литературы
- Friedman J.H. Greedy function approximation: a gradient boosting machine // The Annals of Statistics. – 2001. – Т. 29, № 5. – P. 1189–1232.
- Chen T., Guestrin C. XGBoost: a scalable tree boosting system // Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining. – New York: ACM, 2016. – P. 785–794.
- G. Ke, Q. Meng, T. Finley [et al.]. LightGBM: a highly efficient gradient boosting decision tree // Advances in Neural Information Processing Systems. – 2017. – Т. 30. – P. 3146–3154.
- L. Prokhorenkova, G. Gusev, A. Vorobev [et al.]. CatBoost: unbiased boosting with categorical features // Advances in Neural Information Processing Systems. – 2018. – Т. 31. – P. 6638–6648.
- F. Pedregosa, G. Varoquaux, A. Gramfort [et al.]. Scikit-learn: machine learning in Python // Journal of Machine Learning Research. – 2011. – Т. 12. – P. 2825–2830.
- L. Buitinck, G. Louppe, M. Blondel [et al.]. API design for machine learning software: experiences from the scikit-learn project // ECML PKDD Workshop: Languages for Data Mining and Machine Learning. Prague. – 2013. – P. 108–122.
- Python API Reference [Электронный ресурс]. // XGBoost documentation. [электронный ресурс] – Режим доступа. – URL: https://xgboost.readthedocs.io/
en/ stable/ python/ python_api.html (дата обращения: 31.10.2026). - Python API [Электронный ресурс]. // LightGBM documentation. [электронный ресурс] – Режим доступа. – URL: https://lightgbm.readthedocs.io/
en/ stable/ Python-API.html (дата обращения: 31.10.2026). - CatBoost [Электронный ресурс]. // CatBoost documentation. [электронный ресурс] – Режим доступа. – URL: https://catboost.ai/
docs/ en/ concepts/ python-reference_catboost (дата обращения: 31.10.2026). - G. Booch, R.A. Maksimchuk, M.W. Engle [et al.]. Object-oriented analysis and design with applications. – Upper Saddle River: Addison-Wesley, 2007. – 691 P.
- Э. Гамма, Р. Хелм, Р. Джонсон. Приемы объектно-ориентированного проектирования. Паттерны проектирования. – СПб.: Питер, 2001. – 368 с.
- Мартин Р. Чистая архитектура. Искусство разработки программного обеспечения. – СПб.: Питер, 2018. – 352 с.
- Developing scikit-learn estimators [Электронный ресурс]. // scikit-learn documentation. [электронный ресурс] – Режим доступа. – URL: https://scikit-learn.org/
stable/ developers/ develop.html (дата обращения: 31.10.2026).