Статья опубликована в рамках: Научного журнала «Студенческий» № 34(372)
Рубрика журнала: Информационные технологии
Скачать книгу(-и): Скачать книгу
МЕТОД АВТОМАТИЗИРОВАННОГО ВЫБОРА НЕЙРОСЕТЕВОЙ АРХИТЕКТУРЫ ДЛЯ КРЕДИТНОГО СКОРИНГА НА ОСНОВЕ ПЛАНИРОВАНИЯ ЭКСПЕРИМЕНТА
METHOD OF AUTOMATED NEURAL NETWORK ARCHITECTURE SELECTION FOR CREDIT SCORING BASED ON DESIGN OF EXPERIMENTS
Korchuev Belek Ishembievich
Student, Kyrgyz-German Institute of Applied Informatics,
Kyrgyz Republic, Bishkek
Popov Daniil Borisovich
Student, Kyrgyz-German Institute of Applied Informatics,
Kyrgyz Republic, Bishkek
АННОТАЦИЯ
Предложен метод выбора нейросетевой архитектуры для кредитного скоринга до обучения моделей. Полным факторным экспериментом 23 (240 обучений) установлено влияние объёма выборки, доли дефолтов и представления данных на эффективность сетей MLP, TabNet, Tabular ResNet и LSTM; по уравнениям разностей построен селектор. В проверочных точках селектор выбрал лучшую сеть в 3 из 4 случаев без значимой потери качества, сократив время выбора в 10,7 раза по сравнению с полным перебором. На одних данных точность системы не отличается значимо от скоркарты типа FICO (AUC 0,803 и 0,802).
ABSTRACT
A method is proposed for choosing a neural network architecture for credit scoring before training. A 23 full factorial experiment (240 training runs) quantified the effect of sample size, default rate and data representation on MLP, TabNet, Tabular ResNet and LSTM; a selector was built from difference regression models. At check points the selector chose the best network in 3 of 4 cases with no significant loss and reduced selection time 10.7-fold compared with exhaustive search. On the same data its accuracy does not differ significantly from a FICO-type scorecard (AUC 0.803 vs 0.802).
Ключевые слова: кредитный скоринг; нейронные сети; выбор архитектуры; планирование эксперимента; полный факторный эксперимент; FICO.
Keywords: credit scoring; neural networks; architecture selection; design of experiments; full factorial design; FICO.
Введение
Для табличных кредитных данных предложено много нейросетевых архитектур, но ни одна не превосходит остальные на всех задачах [1; 2]. Поэтому архитектуру обычно выбирают перебором: обучают несколько моделей и сравнивают их на валидации, как в системах AutoML [3]. Затраты перебора растут пропорционально числу кандидатов. Промышленные системы, например FICO Score, используют одну заранее заданную форму модели — сегментированные скоркарты [4]. Ранее авторами рассмотрено применение методов машинного обучения в информационных системах оценки кредитных рисков [5].
Цель работы — построить селектор, который по характеристикам кредитной задачи выбирает архитектуру до обучения, и проверить, что выбранная сеть не уступает лучшей при меньших затратах.
1. Метод
Задача описывается тремя факторами: объёмом обучающей выборки N (x1), долей дефолтов p (x2) и представлением данных (x3 = −1 — срез текущего состояния, x3 = +1 — помесячная история). Область исследования: N = 1 500...12 000, p = 5...22 %. Факторы кодируются как x1 = (N − 6 750)/5 250, x2 = (p − 13,5)/8,5.
Эффективность сети оценивается обобщённым показателем
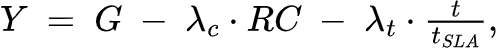 (1)
где G = 2·AUC − 1 — коэффициент Джини; RC = (5·FN + FP)/(5·n·p) — нормированная стоимость ошибок при соотношении цен пропуска дефолта и ложного отказа 5 : 1 (порог решения подбирается по минимуму RC на валидации); t — время ответа на одну заявку, tSLA = 5 мс. В сценарии A λc = 0,5, λt = 0; в сценарии B λc = 0,5, λt = 0,1.
План эксперимента — ПФЭ 23 (8 опытов) с пятью повторениями. Для каждой сети k вычисляется разность с базовой сетью MLP ΔYk = Yk − YMLP и строится уравнение
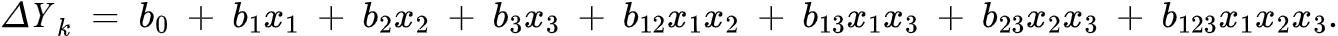 (2)
Однородность дисперсий проверяется критерием Кохрена, значимость коэффициентов — критерием Стьюдента, адекватность — критерием Фишера, кривизна — по опытам в центре плана. Незначимые коэффициенты исключаются; полученные уравнения образуют базу знаний селектора. Правило выбора: если maxk ΔŶk > 0, выбирается сеть с наибольшим ΔŶk, иначе — MLP. Обучается только выбранная сеть.
2. Условия эксперимента
Использованы открытые наборы Default of Credit Card Clients (UCI, 30 000 клиентов, история платежей за 6 месяцев) [6] и Give Me Some Credit (Kaggle, 150 000 заёмщиков) [7]. Выборки заданного объёма и доли дефолтов формировались стратифицированным отбором. Обучено 4 сети × 8 опытов × 5 повторений и 4 сети × 4 проверочные точки × 5 повторений — всего 240 обучений (PyTorch 2.14, pytorch-tabnet 4.1, CPU, 1 поток).
3. Результаты
Коэффициенты b1 и b2 значимы для всех сетей (tкр = 2,04): качество растёт с объёмом выборки и долей дефолтов. Фактор истории b3 значим только для LSTM (b3 = 0,016). Средний Y по плану (сценарий A): MLP 0,128, ResNet 0,124, LSTM 0,124, TabNet 0,077; MLP лучшая в 5 из 8 опытов. Уравнения разностей приведены в таблице 1; все они адекватны по критерию Фишера.
Таблица 1.
База знаний селектора (сценарий A)
|
Сеть |
Уравнение ΔŶ |
Где сеть выгоднее MLP |
|---|---|---|
|
TabNet |
ΔŶ = −0,0509 + 0,0197·x1 |
Нигде в области плана |
|
Tabular ResNet |
ΔŶ = 0 |
Не отличается от MLP |
|
LSTM |
ΔŶ = −0,0165·x2 + 0,0141·x1x2 |
При низкой доле дефолтов (x2 < 0) |
В четырёх проверочных точках вне плана селектор выбрал лучшую сеть в трёх случаях; в четвёртой (UCI, центр плана, история) потеря составила R = 0,008 и незначима (p = 0,553). Средняя потеря по точкам 0,002. Время выбора сократилось в 4,6–17,9 раза (в среднем в 10,7) по сравнению с обучением всех четырёх сетей.
Для сравнения с прототипом построен аналог FICO: квантильное разбиение признаков до 10 интервалов с монотонным объединением, WOE-преобразование и логистическая регрессия [4]. Методы сравнивались в 4 проверочных точках × 5 повторений (таблица 2); различия AUC проверялись парным t-критерием с поправкой Холма [8] и тестом ДеЛонга внутри прогонов [9].
Таблица 2.
Сравнение методов на одних данных (20 прогонов, сценарий A)
|
Метод |
AUC [95 % ДИ] |
RC |
Y |
Обучение, с |
|---|---|---|---|---|
|
Аналог FICO (скоркарта) |
0,802 [0,780; 0,824] |
0,666 |
0,271 |
0,03 |
|
MLP |
0,797 [0,778; 0,817] |
0,688 |
0,251 |
1,4 |
|
TabNet |
0,781 [0,763; 0,798] |
0,714 |
0,204 |
9,6 |
|
Tabular ResNet |
0,792 [0,774; 0,810] |
0,696 |
0,235 |
2,2 |
|
LSTM |
0,804 [0,783; 0,825] |
0,675 |
0,270 |
2,7 |
|
Полный перебор |
0,801 [0,780; 0,822] |
0,678 |
0,263 |
15,9 |
|
Селектор |
0,803 [0,782; 0,824] |
0,673 |
0,269 |
1,6 |
Селектор значимо превосходит фиксированный выбор TabNet (+0,022 AUC, pХолм < 0,001) и ResNet (+0,011, pХолм = 0,002), не отличается от MLP, LSTM и полного перебора и в 9,9 раза быстрее последнего. Различие с аналогом FICO незначимо (+0,0007, pХолм = 0,80); по стоимости ошибок и времени обучения скоркарта немного выгоднее.
4. Обсуждение и ограничения
Внутри области плана селектор фактически выбирает между MLP и LSTM; TabNet уступает MLP при любых значениях факторов. Преимущество метода — не точность, а замена перебора одним обучением при сохранении качества лучшей сети. Ограничения: в моделях Y всех сетей значима кривизна в центре плана (t = 2,39...4,41), поэтому прогноз самой величины Y требует плана второго порядка (в моделях разностей ΔY кривизна незначима, и для выбора сети уравнений первого порядка достаточно); дисперсии разностей ΔY неоднородны по критерию Кохрена, и значимость коэффициентов следует понимать с этой оговоркой; проверочных точек всего четыре; база знаний требует 240 обучений и окупается при многократном использовании; данные не относятся к региону Центральной Азии; соотношение цен ошибок 5 : 1 принято как допущение.
Заключение
Предложен и экспериментально проверен метод выбора нейросетевой архитектуры для кредитного скоринга на основе ПФЭ 23. Селектор сохраняет качество лучшей сети (потеря 0,002) и сокращает время выбора в 10,7 раза; по точности он сопоставим со скоркартой типа FICO. Направления развития — план второго порядка, расширение набора архитектур и проверка на региональных данных.
Список литературы:
- Arik S. Ö., Pfister T. TabNet: Attentive Interpretable Tabular Learning // Proceedings of the AAAI Conference on Artificial Intelligence. – 2021. – Vol. 35, No. 8. – P. 6679–6687.
- Revisiting Deep Learning Models for Tabular Data / Y. Gorishniy [et al.] // Advances in Neural Information Processing Systems. – 2021. – Vol. 34. – P. 18932–18943.
- AutoGluon-Tabular: Robust and Accurate AutoML for Structured Data [Электронный ресурс] / N. Erickson [et al.] // arXiv. – 2020. – arXiv:2003.06505. – URL: https://arxiv.org/abs/2003.06505 (дата обращения: 16.10.2026).
- Fahner G. Developing Transparent Credit Risk Scorecards More Effectively [Электронный ресурс] / FICO. – Philadelphia : Federal Reserve Bank of Philadelphia, 2018. – URL: адрес (дата обращения: дд.мм.2026).
- Корчуев Б. И., Попов Д. Б. Применение методов машинного обучения при разработке аналитических информационных систем оценки кредитных рисков // Название журнала / сборника. – 2026. – № выпуска. – С. страницы.
- Yeh I.-C., Lien C. The comparisons of data mining techniques for the predictive accuracy of probability of default of credit card clients // Expert Systems with Applications. – 2009. – Vol. 36, No. 2. – P. 2473–2480.
- Give Me Some Credit [Электронный ресурс] : Kaggle competition dataset // Kaggle. – 2011. – URL: https://www.kaggle.com/c/GiveMeSomeCredit (дата обращения: 16.10.2026).
- Holm S. A simple sequentially rejective multiple test procedure // Scandinavian Journal of Statistics. – 1979. – Vol. 6, No. 2. – P. 65–70.
- DeLong E. R., DeLong D. M., Clarke-Pearson D. L. Comparing the areas under two or more correlated receiver operating characteristic curves: a nonparametric approach // Biometrics. – 1988. – Vol. 44, No. 3. – P. 837–845.